高速検索
2,000 万件+件のデータで大規模実測、検索は数秒以内
大量の文書や記録の中から、必要な情報を素早く特定します。大規模実測では、DocLake は 2,000 万件を超えるデータを処理し、検索結果を数秒以内に返しています。
 ARX DocLake
高度な規制業種、機密データ、そしてネットワークから切り離された環境のために設計された、プライベートな文書インテリジェンスプラットフォーム。
企業が積み上げてきた大量の PDF、スキャン文書、技術資料、過去のアーカイブは、機密性が高い、あるいはクラウドに移行できないという理由だけで、検索や AI 活用が難しいままであるべきではありません。 ARX DocLake は、文書認識、データ前処理、インデックス作成、高速検索、そして AI による質問応答を、単一のオンプレミスプラットフォームに統合します。大量の原本文書から、検索可能で対話可能なプライベートナレッジへ至るまでの全工程を、企業のネットワーク内で完結できます。
原本文書から検索可能なナレッジまで、複数のシステムを自前で統合する必要はありません。
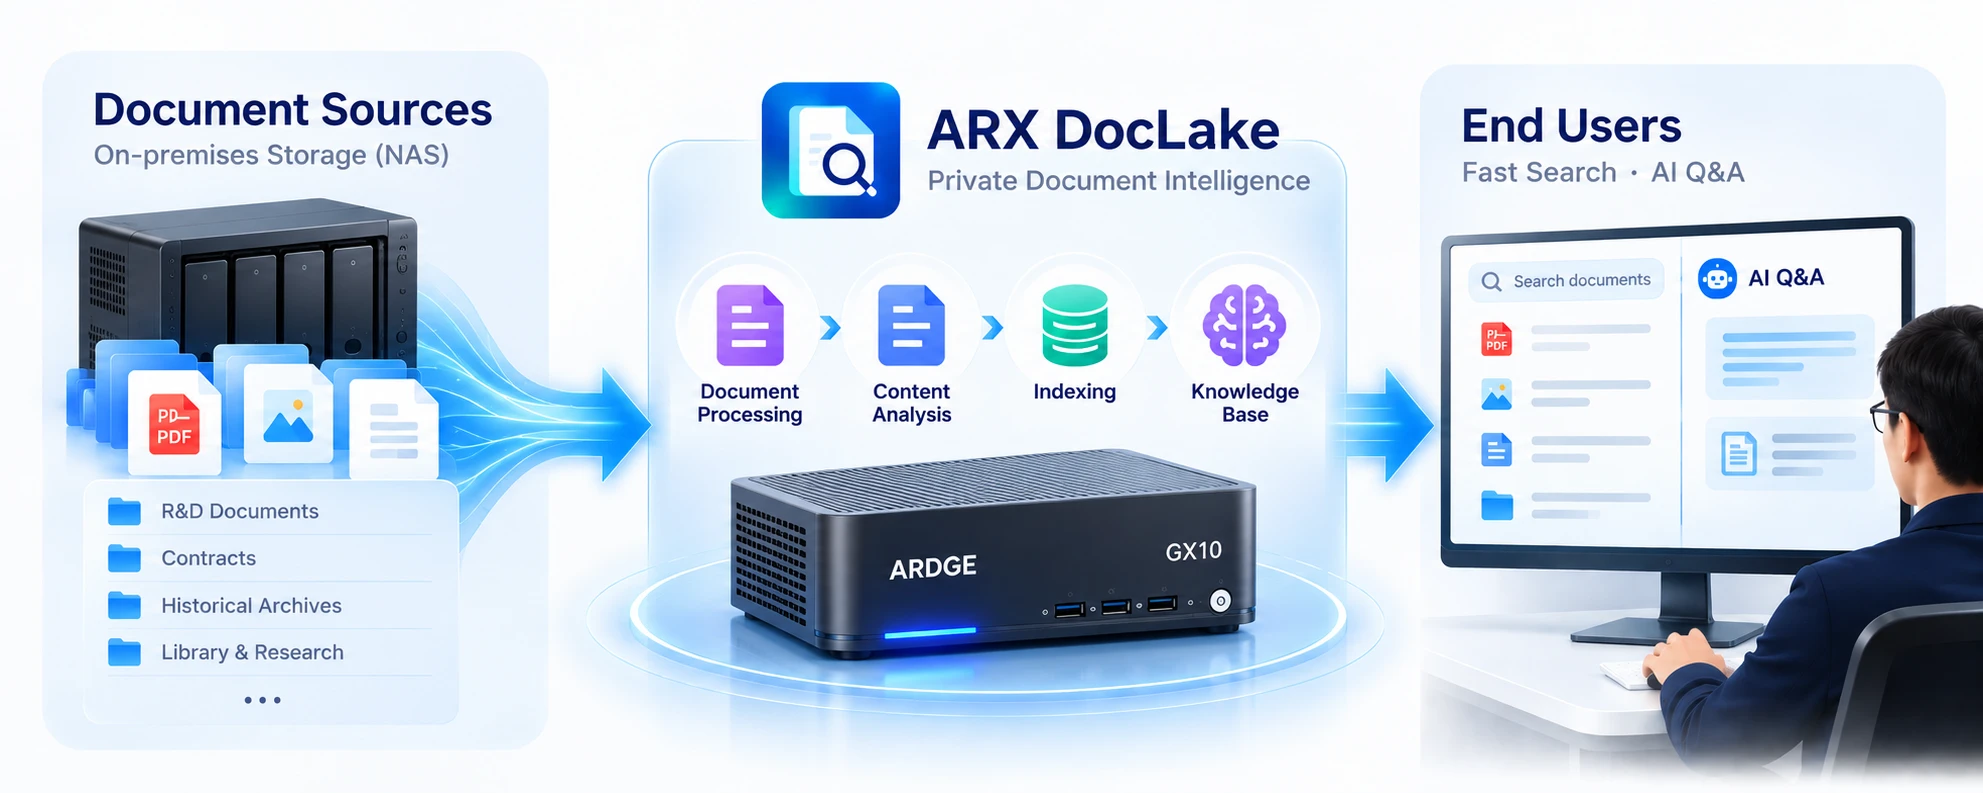
PDF、スキャン文書、画像をローカルストレージまたはネットワーク接続ストレージ(NAS)に集約するだけで、スケジュールに沿ったバッチ処理が可能になります。 DocLake は文書認識と AI 前処理機能を内蔵しており、原本文書を検索や AI 利用に適した内容へ自動的に変換します。インデックス作成後は、部門、プロジェクト、または情報の種類ごとに、それぞれ独立したナレッジライブラリを構築できます。
取り込みから処理、インデックス作成、ナレッジライブラリの構築まで、DocLake 一つで完結します。
PDF、スキャン文書、画像をローカルまたは NAS に保存
文書認識と AI 前処理を、スケジュールされたバッチで実行
検索と AI 利用に適した内容へ変換
部門、プロジェクト、情報の種類ごとに構築
大量の文書を、一つずつ開いて探す必要はもうありません。同じ DocLake ナレッジライブラリが、高速検索と AI による質問応答の両方に対応します。
2,000 万件+件のデータで大規模実測、検索は数秒以内
大量の文書や記録の中から、必要な情報を素早く特定します。大規模実測では、DocLake は 2,000 万件を超えるデータを処理し、検索結果を数秒以内に返しています。
大量の文書内容について自然言語でそのまま質問し、AI に検索・理解・整理・回答をまかせられます。
原本データが必要なときは検索を。内容の理解が必要なときは、そのまま AI に質問を。
文書処理から AI による質問応答まで、すべて自社の環境内で完結します。
原本文書、文字認識、データ前処理から、インデックス作成、検索、AI による質問応答まで、DocLake は企業のネットワーク内だけで完全に稼働できます。 機密文書、研究開発データ、知的財産、過去のアーカイブ、そして問い合わせ内容を、パブリックな AI サービスへ送信する必要はありません。
DocLake は、データ主権、機密性、法規制への準拠、知的財産保護、そしてネットワーク分離を重視する企業のために設計されており、完全にネットワークから切り離された Air-Gap 環境にも導入できます。
コンパクトに導入でき、着実に拡張できます。
20 万ページ規模
約 20 万ページ規模の文書ナレッジ環境に適しています。
50 万ページ規模
約 50 万ページ規模の文書ナレッジ環境に適しています。
DocLake は、ARX-100 とネットワーク接続ストレージ(NAS)を組み合わせたコンパクトな一体型構成から導入を始められます。文書量、処理負荷、パフォーマンス要件の増加に応じて、コンピュートとストレージのリソースを拡張しながら、一貫した DocLake の利用体験を維持できます。
* ページ数は推奨導入規模を示すものであり、処理の上限ではありません。
DocLake は API、MCP(Model Context Protocol)、CLI を通じて、企業の既存システム、AI アシスタント、自動化ワークフローと連携できます。 機密性の高い情報は企業内に留めたまま検索とナレッジ処理を行いつつ、必要に応じて他の AI システムやハイブリッドアーキテクチャと連携する柔軟性も維持できます。
DocLake は、大量のプライベート文書を、企業 AI が継続的に活用できるナレッジソースへと変えます。
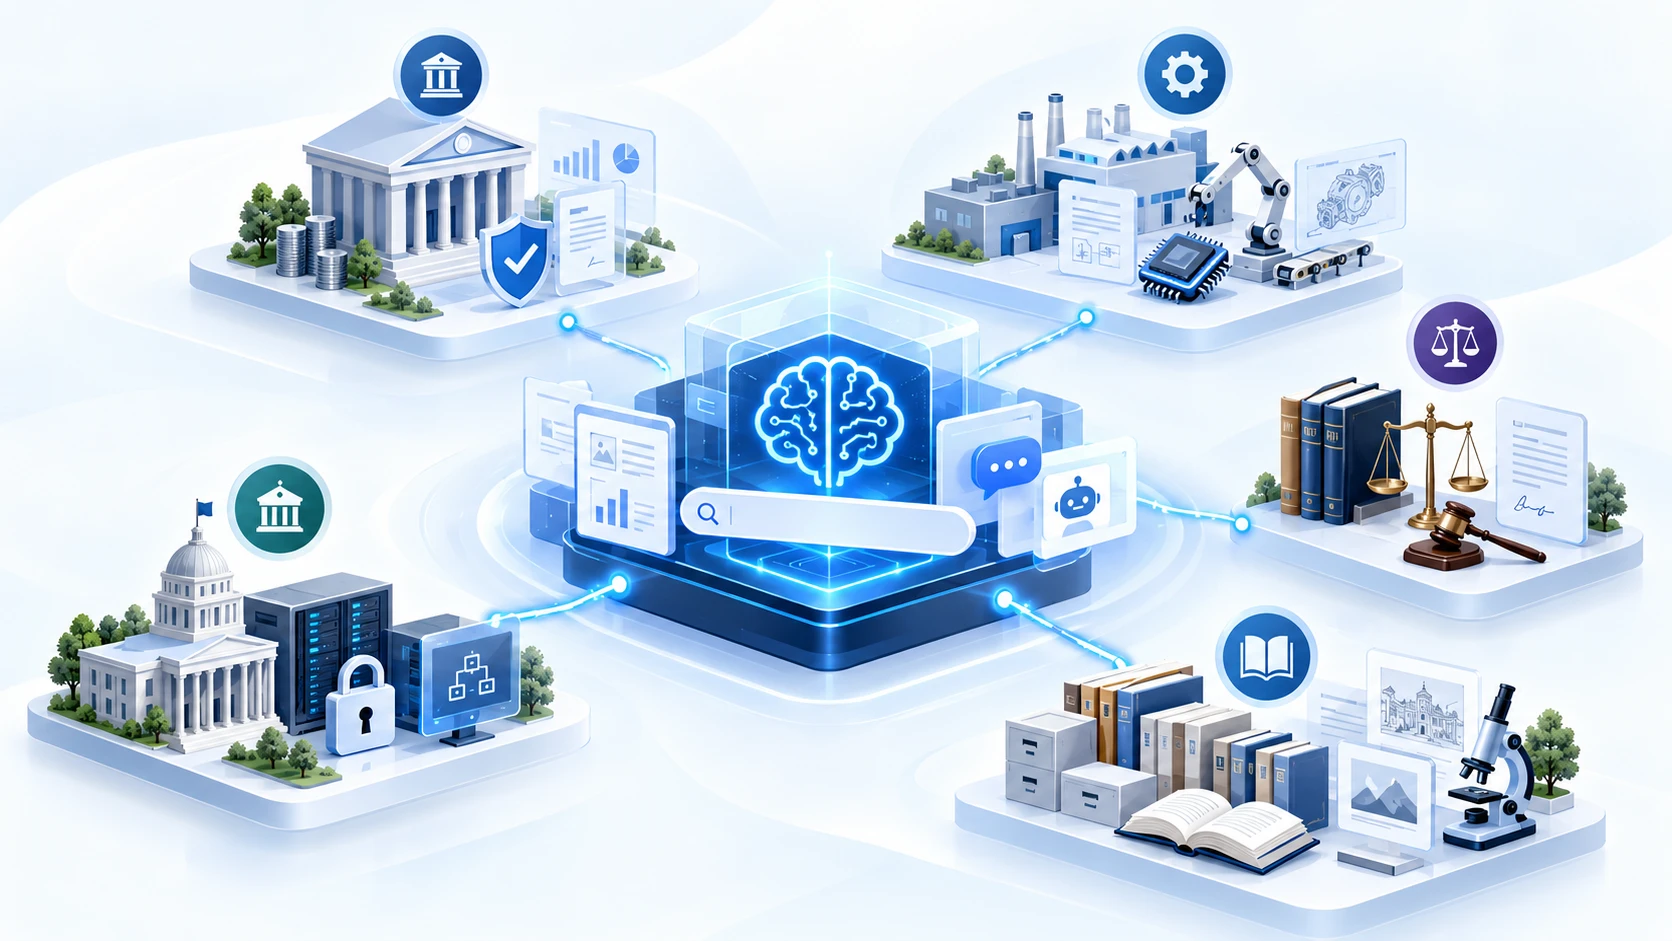
コンプライアンス文書、内部記録、過去のデータ、機密ナレッジを素早く検索します。
研究開発データ、技術文書、製造プロセスに関するナレッジ、知的財産を保護しながら、AI で検索と理解を加速します。
大量の案件、契約書、証拠資料、過去の文書の中から、必要な情報を素早く見つけ出します。
内部ネットワークまたは完全に切り離された環境の中で、機密文書とプライベートナレッジを処理します。
大量の書籍、研究資料、スキャン文書、歴史的アーカイブを、データ主権を保ったまま高速検索と AI 質問応答で活用できるようにします。
NAS、ファイルサーバー、過去のデータベースに眠る文書を、高速検索・理解・活用ができる企業ナレッジへと変えます。